介绍
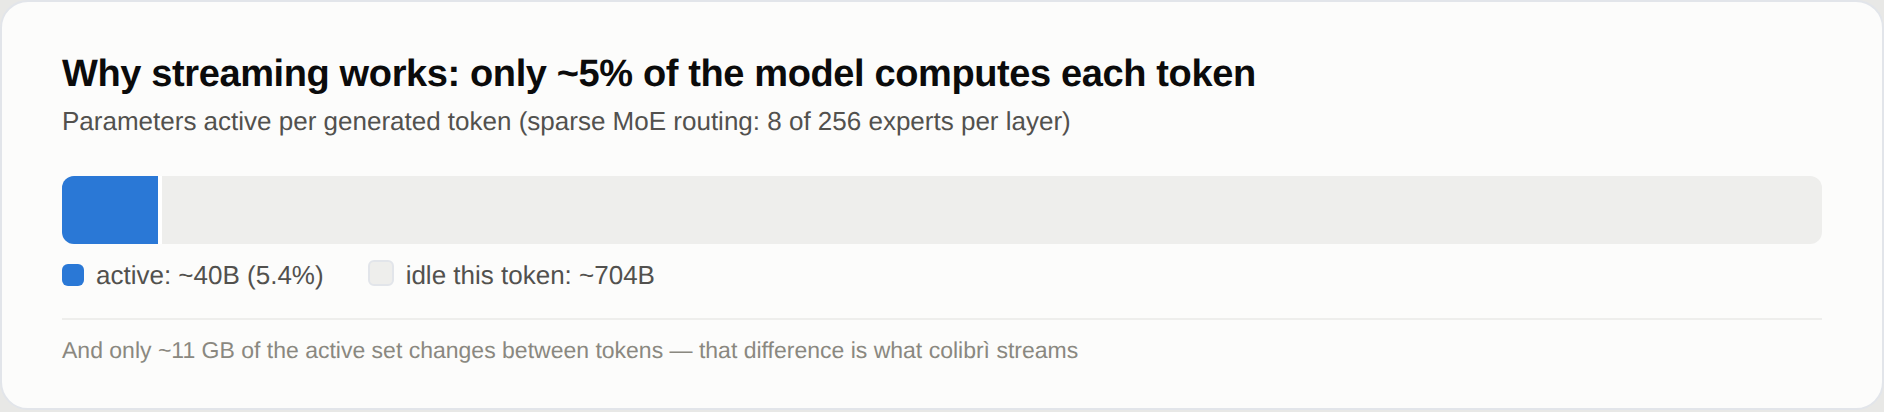
Apache-2.0 协议,纯 C 写的推理引擎,五万两千多星。它赌的一件事是:MoE 大模型「盘上很大、每个 token 却很小」——GLM-5.2 有 744B 参数、下载要 429GB,但每生成一个 token 只用得到约 40B,其中相邻 token 之间真正会变化的只有 11GB 左右。【"家用电脑跑大模型"喊了很久,它是第一个把数字摊开给你看的】
办法是把内存分层摆:稠密部分(注意力、共享专家、词表)常驻内存,路由专家留在 NVMe 上按需读,再靠一个从你自己对话里学出来的缓存决定把谁升级进显存。工程上做得挺抠——一个专家的三个矩阵用一次 pread 读完、算常驻专家时并发预读缺失专家、同一批里每个专家只读一次、用 router 预判下一层要读谁,GLM-5.2 单层路由有 71.6% 能被猜中。
关键是它没吹牛,实测表格带着硬件:25GB 内存的笔记本跑 GLM-5.2 是 0.05–0.1 tok/s(基本就是能跑起来看看);128GB 的 Ryzen AI Max+ 395 纯 CPU 1.83 tok/s;六张 RTX 5090 全驻留 9.0–9.2 tok/s。小一点的 Qwen3.6-35B-A3B(23GB)在 RTX PRO 4000 上能干到 104.8 tok/s。作者也把限制写在明处:8GB 内存能起、建议 16GB 以上,模型目录别放 WSL 的 /mnt/c,35B 以下才谈得上流畅。
安装是给普通人准备的:Windows 下载 ZIP 双击 START-HERE.bat(缺 Python 会自己装),Linux/macOS 跑 ./start-here.sh,它探测你的内存、磁盘、显卡,推荐装得下的最大模型,然后起一个 OpenAI 兼容服务:http://127.0.0.1:8000/v1。Claude Code 或任何 OpenAI 兼容编辑器把 base URL 改过去就能接本地大模型。
特征
🧠 冷热专家三层驻留:显存 → 内存 → NVMe 流式读
📊 13 个引擎,一个模型家族一个 .c 文件
💾 直接吃现成 GGUF,IQ1_S 到 BF16 原样跑,不重新量化
🩺 coli plan 告诉你模型将住在哪层、coli doctor 做体检、coli tune 实测最优参数
🖥️ CPU / Vulkan / CUDA 三种后端,集显也能分担专家
💿 COLI_MODEL_MIRROR 双 NVMe 镜像,实测 decode 提升 37.5%
⚡ 投机解码按需开关,Qwen3.6 的 MTP 把速度推到 120 tok/s
🧮 MLA 每 token 只存 576 个浮点,比常规少 57 倍
📈 dashboard 把每次触发的专家可视化出来
🔌 自带 MCP server,也能出图(Qwen-Image-2.1)和跑决策模型